
Riconosci testo (OCR) nei PDF
Sì, su iPhone, iPad e Android, senza caricare il file.
Per piattaforma
| iPhone e iPad | Approssimata | Cosa si perde: Il testo riconosciuto può contenere errori: l’accuratezza non è garantita sulle scansioni difficili. |
|---|---|---|
| Android | Approssimata | Cosa si perde: Il testo riconosciuto può contenere errori: l’accuratezza non è garantita sulle scansioni difficili. |
Come si fa
- Importa i PDF, oppure condividili con Tramuta.
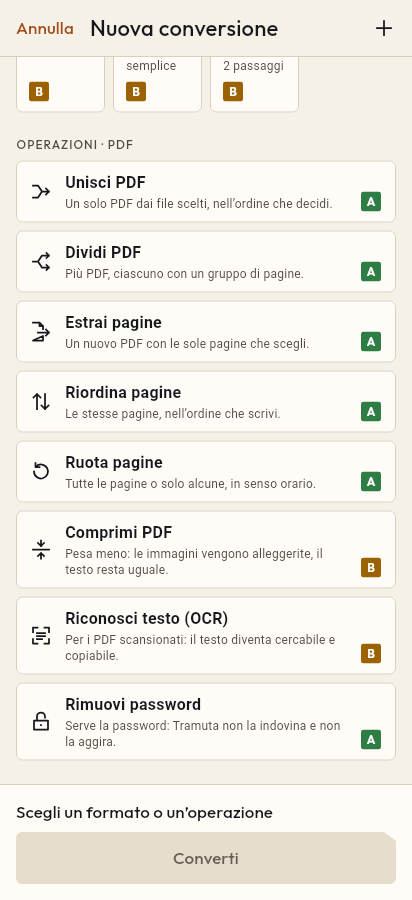
- Scegli «Riconosci testo (OCR)» fra le operazioni.
- Tocca «Converti», poi «Condividi» o «Salva in…».
Una scansione è una fila di fotografie: puoi leggerla, ma non cercarci una parola, copiare un indirizzo o incollare un paragrafo in una mail. «Riconosci testo (OCR)» legge le pagine e ne ricava il testo, in italiano e in inglese, sul telefono, sul tablet o sul pieghevole. Le pagine non vengono caricate da nessuna parte: per documenti come contratti, referti o buste paga è il punto.
Cosa aspettarsi dal riconoscimento del testo (OCR)
L’OCR è «Approssimata» su iPhone, iPad e Android, e l’app lo dice prima di partire: «Il testo riconosciuto può contenere errori: l’accuratezza non è garantita sulle scansioni difficili.» Conviene rileggere il testo riconosciuto prima di usarlo, soprattutto se la scansione è storta o poco nitida.
Puoi scegliere fra due risultati:
- «PDF ricercabile»: un PDF nuovo con una pagina per ogni pagina riconosciuta, grande come l’originale. Sotto c’è l’immagine della pagina, sopra un livello di testo invisibile: selezioni e ricerche cadono sulle parole che vedi. Nel livello invisibile i caratteri che il suo font non prevede vengono sostituiti; l’immagine resta comunque quella originale. Il file esce con «ricercabile» nel nome.
- «Solo testo (TXT)»: solo il testo, pagina dopo pagina, separate da una riga vuota. Una pagina senza niente da leggere resta vuota, così vedi dove il riconoscimento non ha trovato testo.
iPhone e iPad, Android: due motori, nessuna rete
Su iPhone e iPad il testo lo riconosce Vision, il motore di Apple incluso nel sistema. Su Android lavora Tesseract, con i modelli per l’italiano e l’inglese inclusi nell’app. ML Kit di Google è stato escluso apposta, perché invierebbe dati d’uso a Google. In tutti e due i casi le pagine vengono prima rese come immagini da PDFium e poi passate al motore, una alla volta.
Le opzioni del riconoscimento
- «Lingue del testo»: «Italiano e inglese» (predefinito), «Italiano», «Inglese».
- «Risoluzione del riconoscimento»: da 200 a 400 DPI, predefinito 300. Più alta legge meglio i caratteri piccoli, ma ci mette di più.
- «Pagine»: vuoto vuol dire tutte, oppure intervalli come 1-3, 5, 8-.
- «Password del PDF»: solo se il PDF è protetto. Tramuta non la salva.
- «Risultato»: «PDF ricercabile» o «Solo testo (TXT)».
Come fare l’OCR di un PDF con Tramuta
- Apri Tramuta e tocca «Scegli o trascina dei file», oppure condividi la scansione con «Condividi» o «Apri con».
- In «Operazioni · PDF» tocca «Riconosci testo (OCR)».
- In «Opzioni» scegli lingue, risoluzione e «Risultato».
- Tocca «Riconosci».
- Dal risultato: «Condividi», «Salva in…» o «Apri con…».
Se le pagine sono girate, raddrizzale prima con Ruota pagine. Un PDF ricercabile pesante si può alleggerire dopo con Comprimi PDF. Per un PDF che ha già testo vero, usa PDF in TXT.
Domande
In quali lingue riconosce il testo?
Italiano e inglese, insieme o separati: in «Lingue del testo» scegli «Italiano e inglese», «Italiano» o «Inglese». Con la lingua giusta il riconoscimento sbaglia meno.
Il PDF ricercabile ha lo stesso aspetto della scansione?
Sì: ogni pagina è l’immagine della pagina originale, con sopra un livello di testo invisibile che serve a cercare e copiare. Le pagine dove non c’è niente da leggere restano solo immagine.
Serve una connessione per l’OCR?
No. Su iPhone e iPad riconosce Vision, il motore di sistema; su Android Tesseract con i modelli italiano e inglese già dentro l’app. Le pagine non lasciano il dispositivo.
Il mio PDF ha già del testo selezionabile: devo usare l’OCR?
Di solito no. Per un PDF con testo vero conviene «PDF in TXT», che legge il testo così com’è, senza errori di riconoscimento e senza trasformare le pagine in immagini.
Gratis su iPhone, iPad e Android
Senza pubblicità, senza acquisti in-app, senza account.
-
App Store
iPhone e iPad, iOS 15.0 o successivo.
In arrivo su App Store -
Google Play
Android 7.0 o successivo.
In arrivo su Google Play -
APK per Android
Android 7.0 o successivo, senza Google Play.
L’APK non è ancora disponibile.